一、产业拐点:2026端侧AI规模化落地元年
端侧AI,即在手机、PC、汽车、可穿戴设备、机器人等终端设备本地运行AI模型,直接在终端完成推理计算,无需将数据上传至云端服务器处理。2026年,端侧智能正从概念验证迈向规模落地,产业化拐点已然到来。北京智源人工智能研究院与端侧智能北京市重点实验室联合发布的《端侧智能2026:规模化落地元年》报告指出,大模型产业正经历从“云端集中式智能”走向“端云协同式智能”的结构性跃迁。
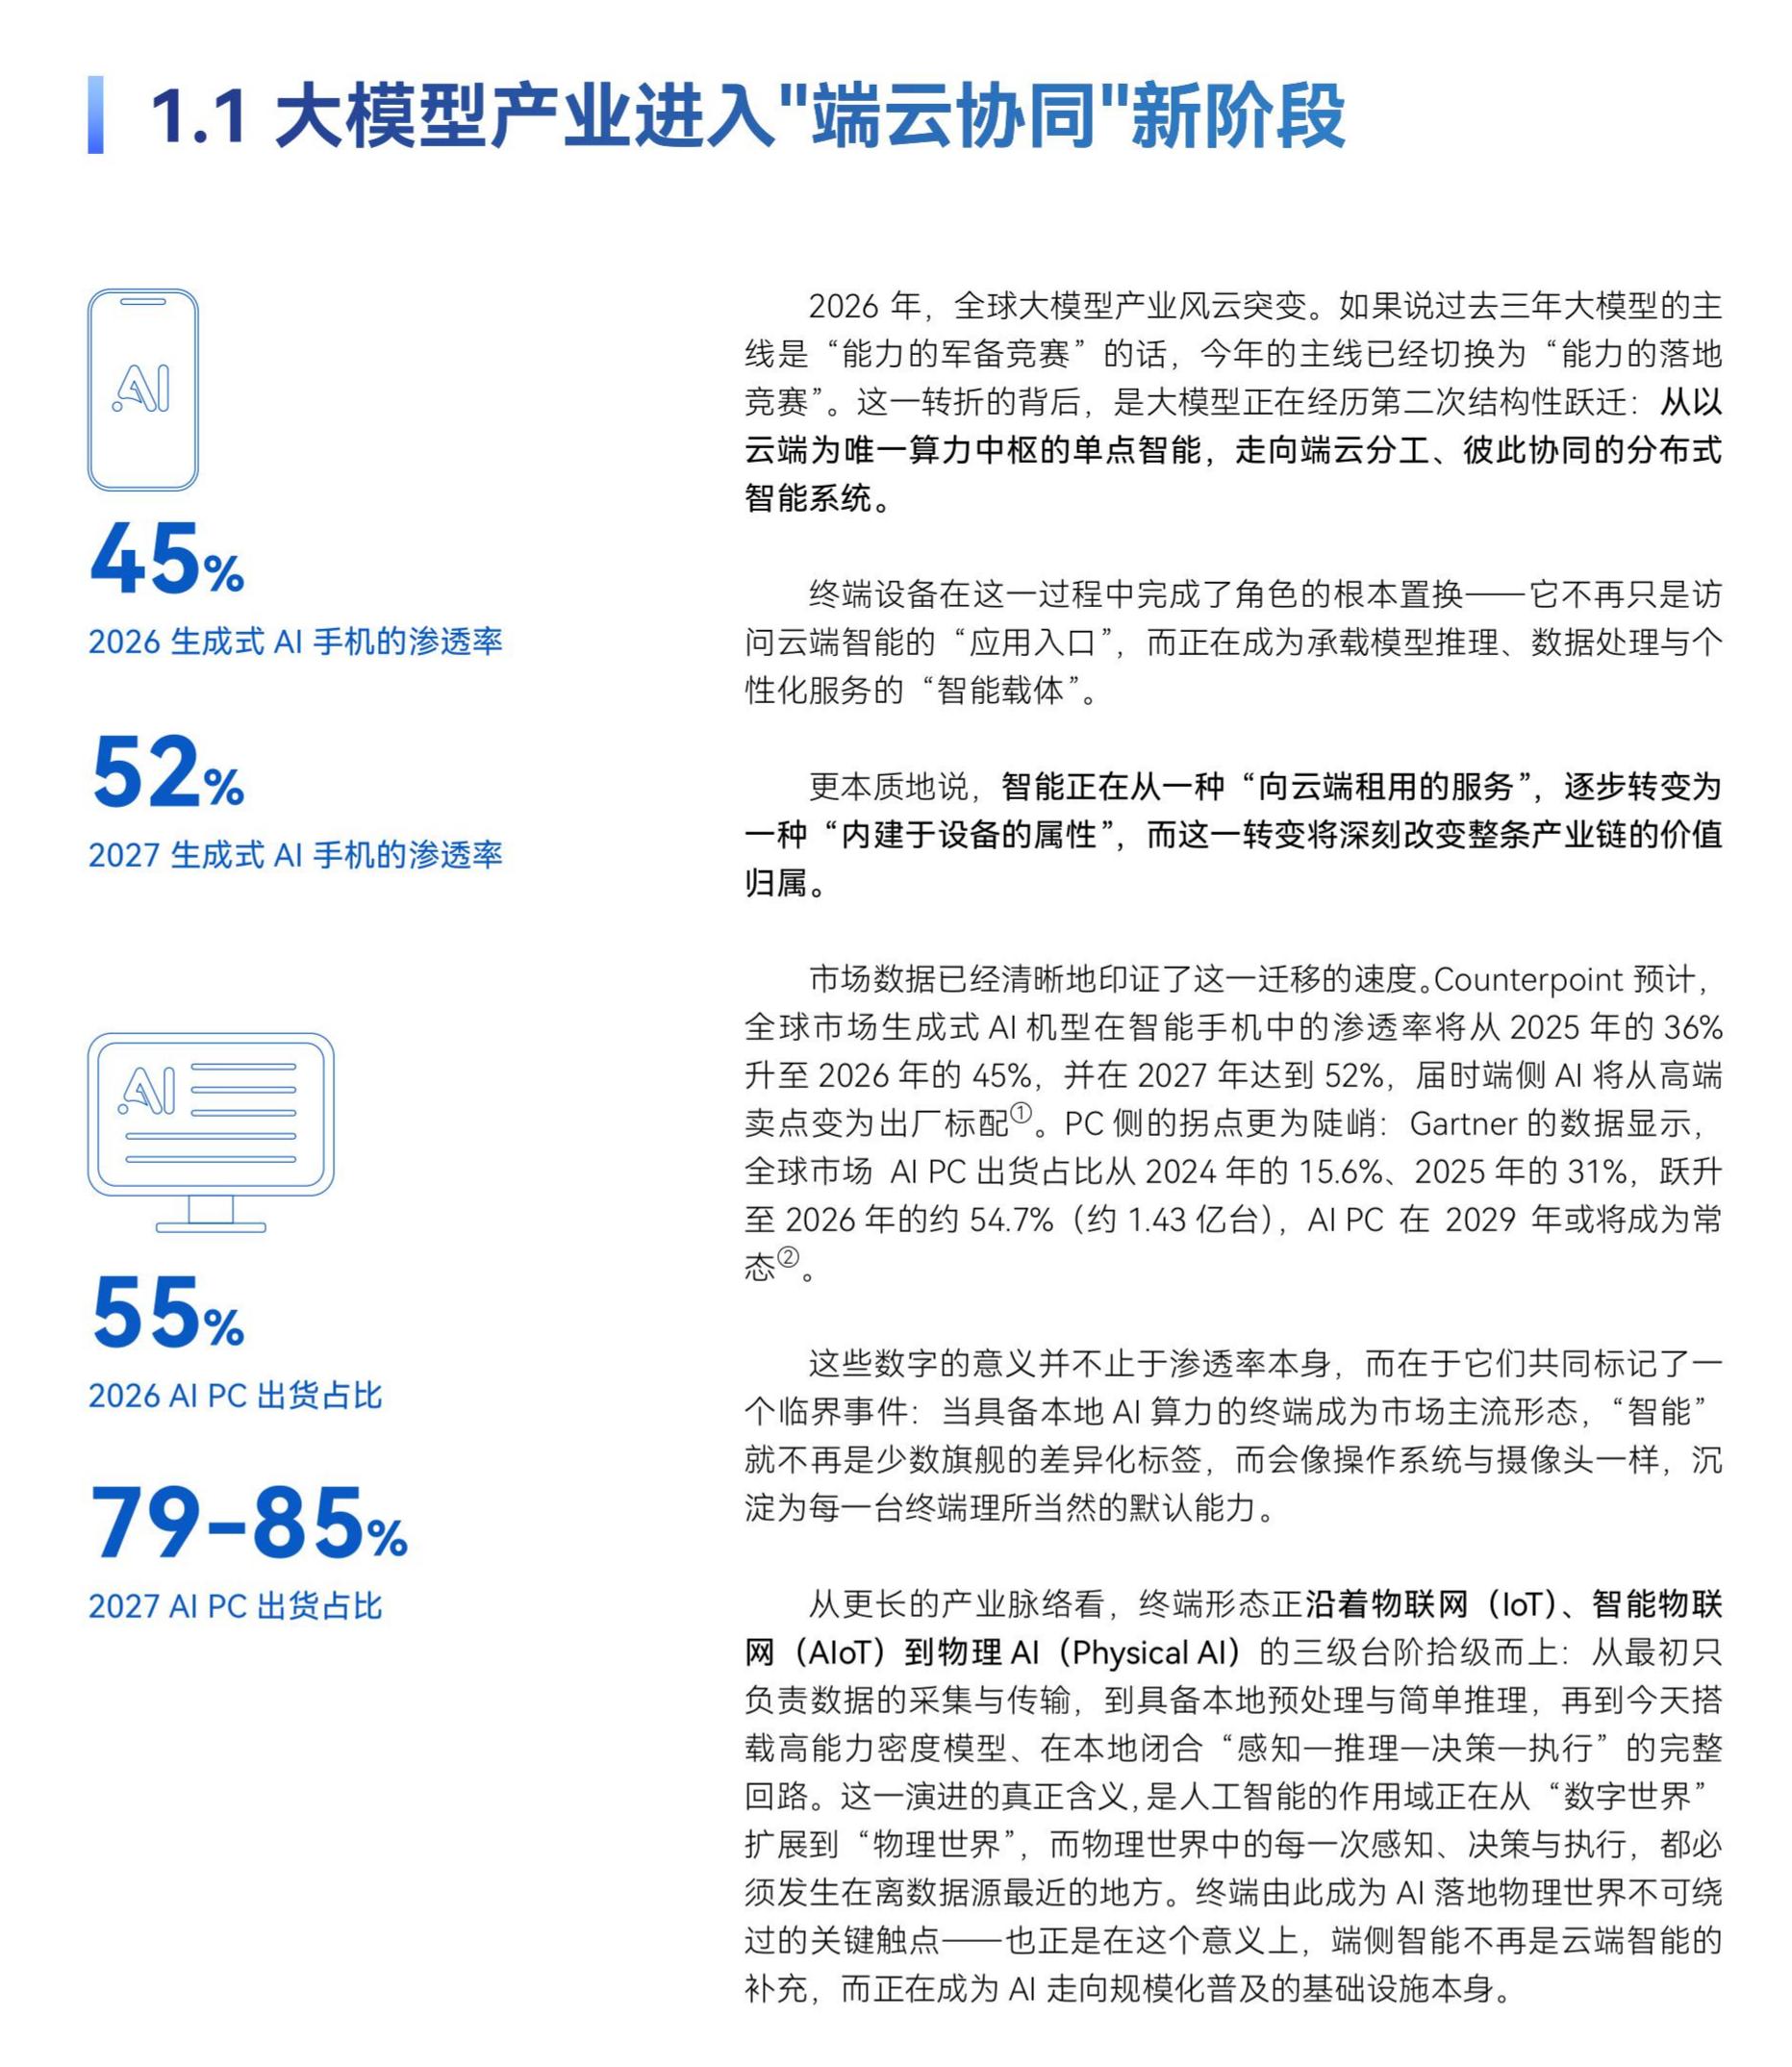
产业界的共识正在形成:2026年是端侧AI规模化落地的元年,大模型正在从云端走向手机、汽车、机器人等终端设备,AI从“能聊”走向“能干”。2026世界人工智能大会上,努比亚豆包AI手机、夸克AI眼镜等多类端侧硬件密集展示,端侧AI的落地成为最热门的讨论话题之一。
市场规模层面,2026年端侧AI市场规模预计突破8000亿元,AI推理计算需求将达到训练需求的4到5倍。弗若斯特沙利文预测,全球端侧AI市场规模将从2025年的3219亿元跃升至2029年的1.22万亿元,年复合增长率达40%。IDC数据显示,2026年中国AI手机出货量将达1.47亿台,同比增长31.6%,在整体市场中占比突破53%。2026年第一季度全球端侧AI芯片出货量同比增长78%。
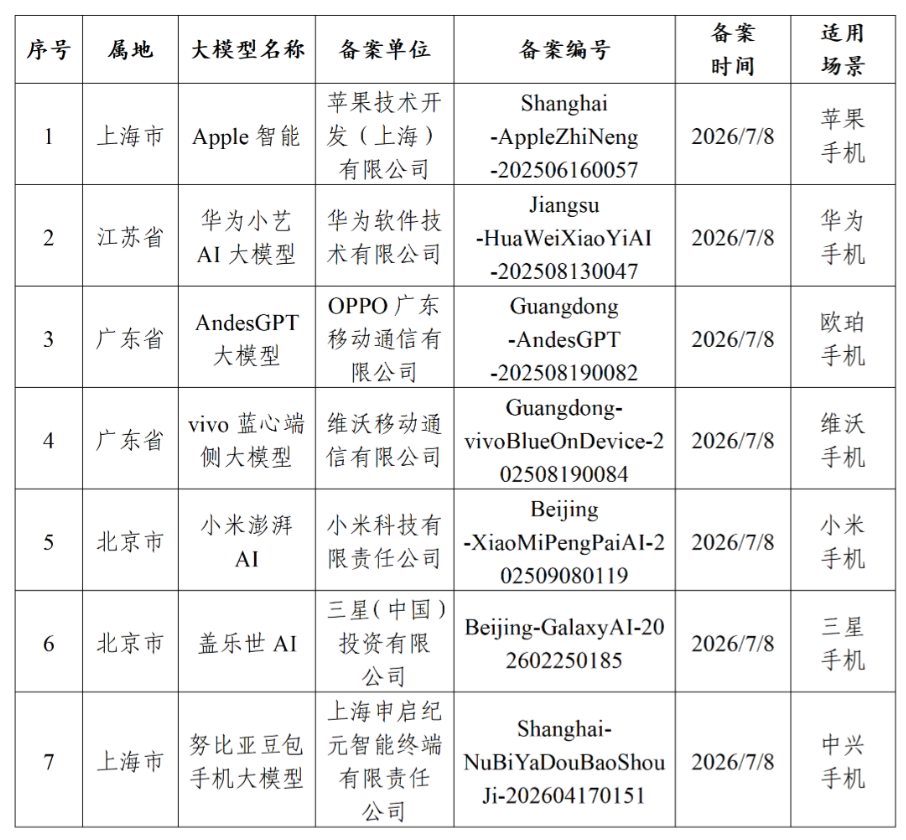
政策层面,《关于深入实施“人工智能+”行动的意见》提出,到2027年新一代智能终端、智能体等应用普及率超70%。7月15日,国家网信办首次公布7款手机端侧大模型备案名单,端侧AI正式进入标准化、合规化发展新阶段。
二、端侧AI爆发式增长的三大核心驱动力
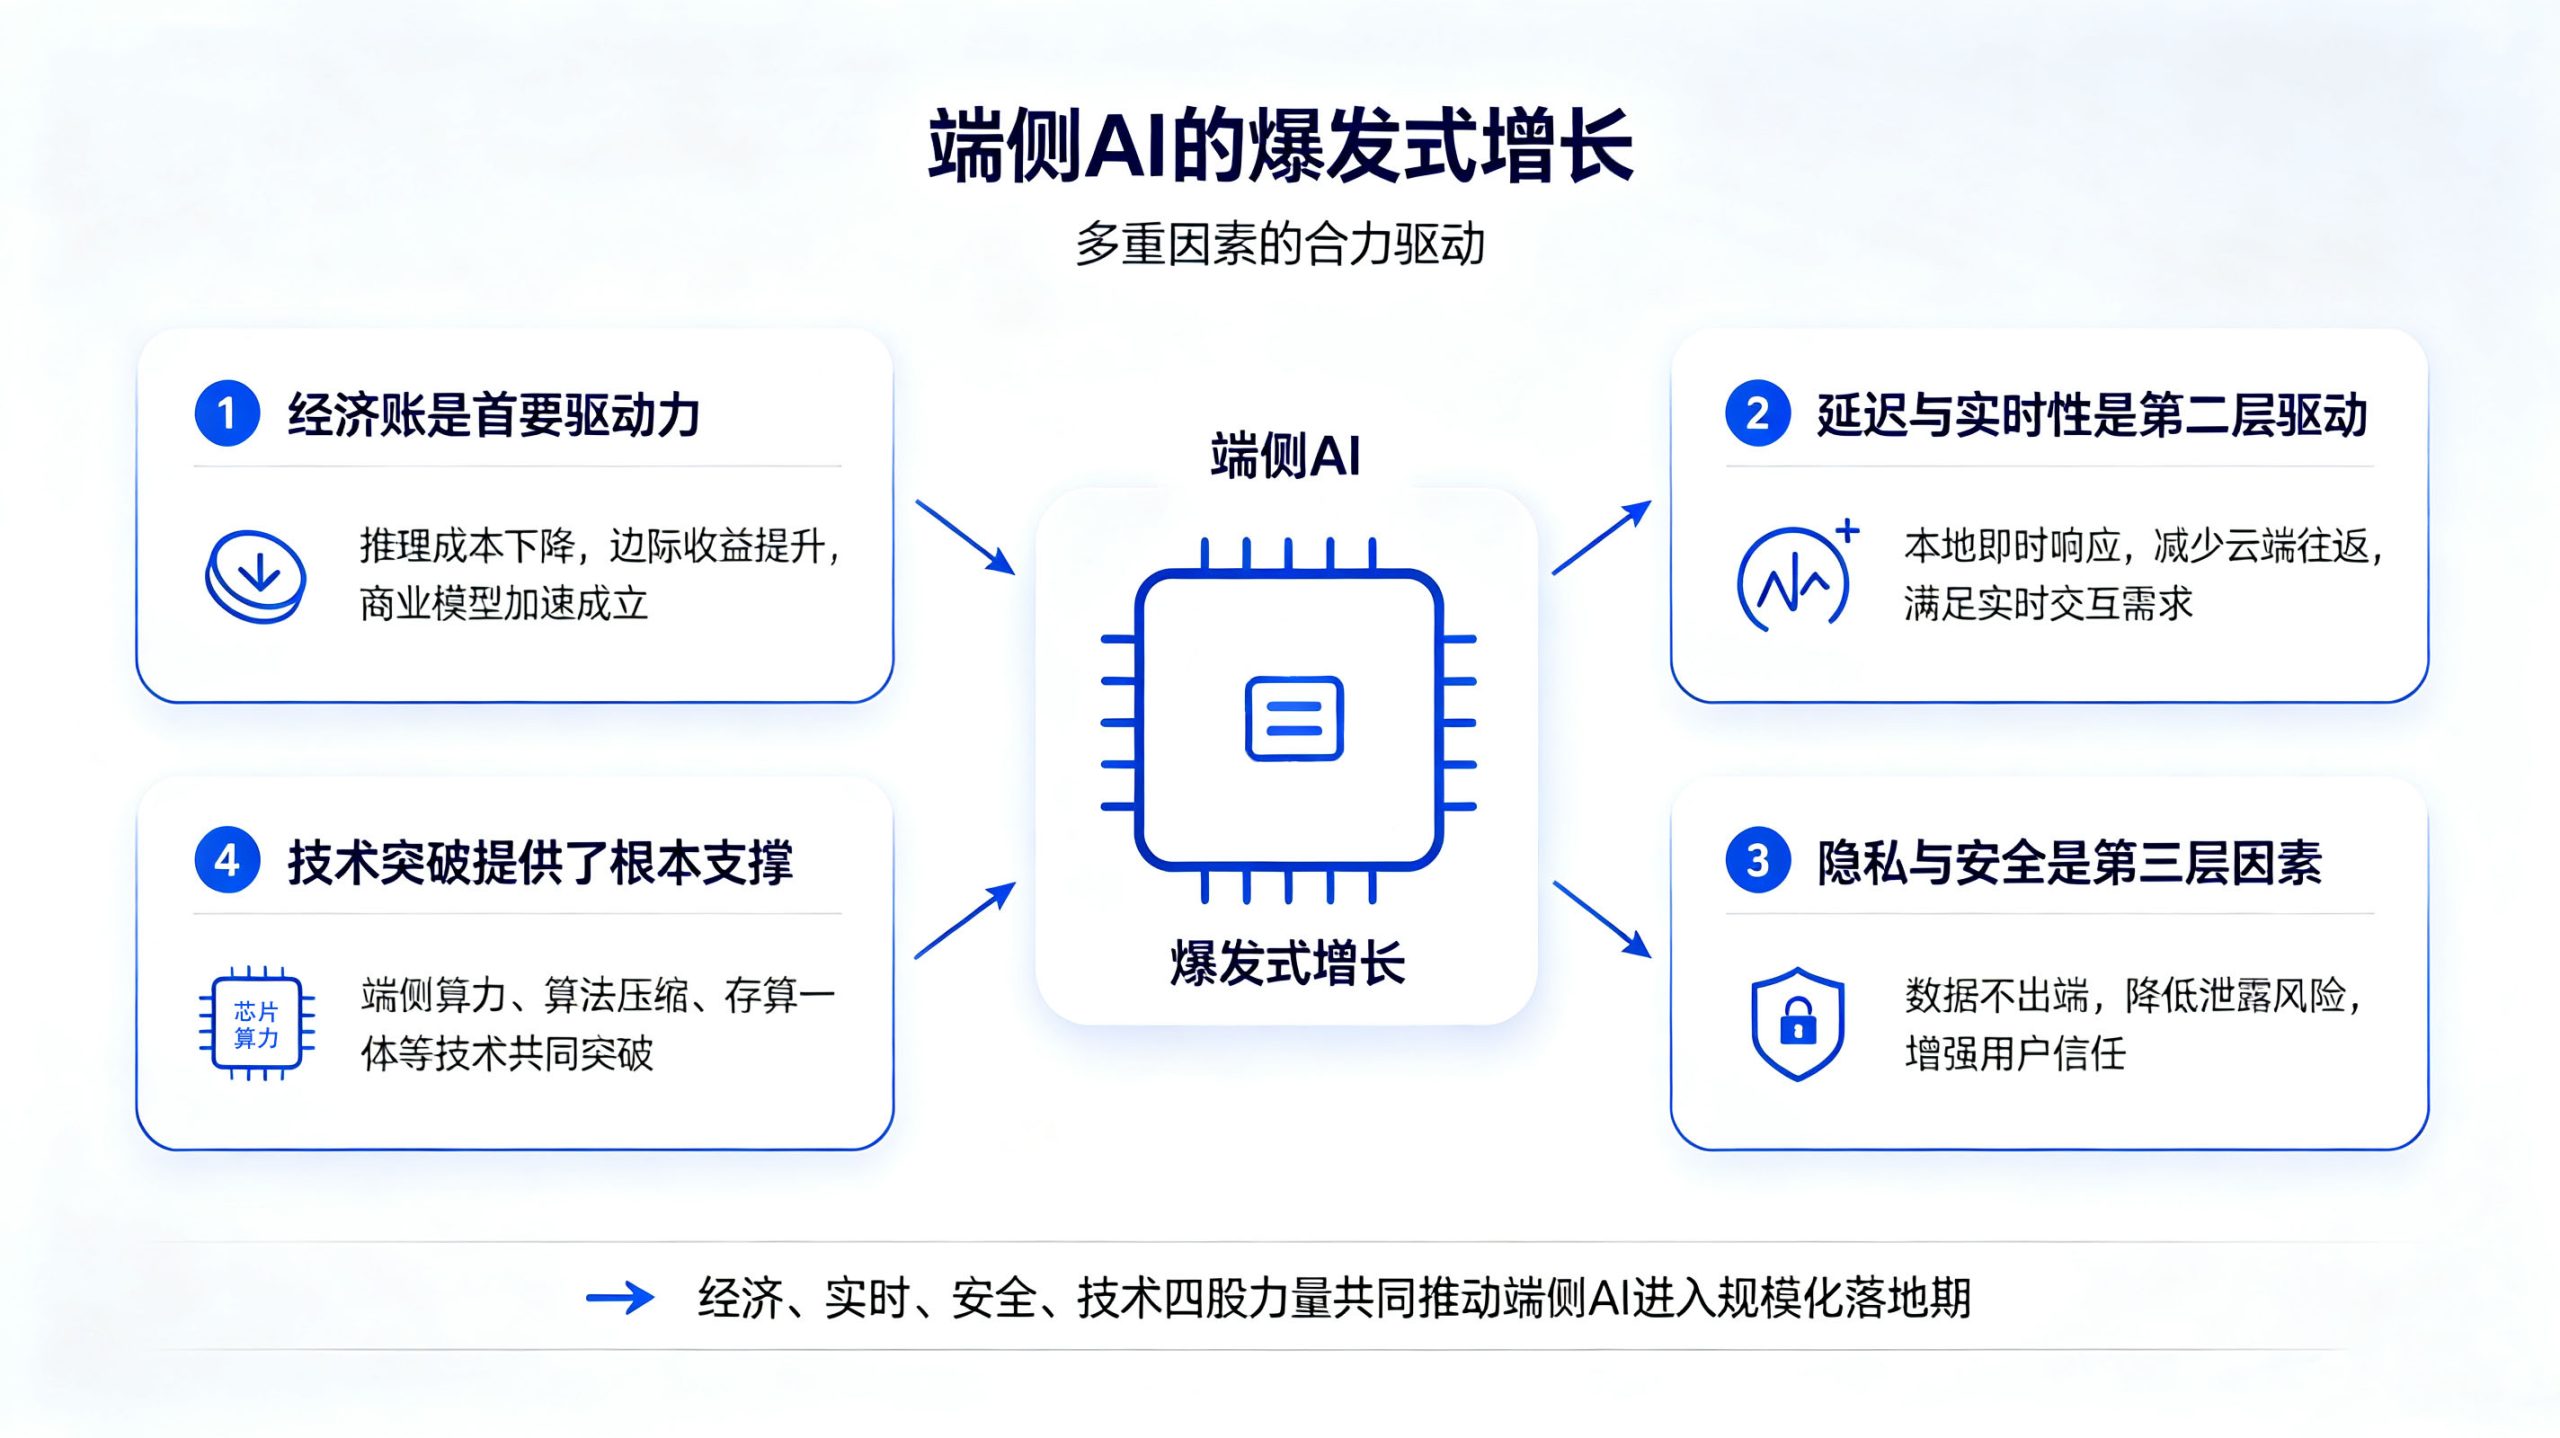
端侧AI的爆发式增长,源于多重因素的合力驱动。
经济账是首要驱动力。推理一旦成为高频、持续的行为,全走云端在成本上将难以承受——一次推理调用看似不多,但一天几亿次累加起来是一笔惊人的支出。大量应用方案公司已在要求芯片厂商提供本地加云端的混合方案。某深圳公司搭建的端云混合Agent平台运行后显示,约80%的任务可在本地完成,仅20%需要上云。经济账一旦跑通,迁移就是不可逆的。
延迟与实时性是第二层驱动。端侧推理能做到毫秒级响应,云端推理则受制于网络环境,对于自动驾驶紧急避障等需要实时交互的场景,延迟是会破坏任务的硬伤。
隐私与安全是第三层因素。本地处理意味着照片、文件、视频等数据始终留在本地设备里,安全且离线可用。数据即资产的认知越来越普遍,敏感信息不便来回传输的场景下,端侧AI的差异化优势显著。
技术突破提供了根本支撑。模型蒸馏、量化压缩等技术的成熟,以及终端设备硬件能力的跃升,“把高性能大模型装进终端”从设想变成工程现实。尤其是“密度定律”(DensingLaw)的提出——大模型最大能力密度约每3.5个月翻一番,而芯片算力约每两年翻一倍——两条曲线的交汇,从根本上改变了端侧AI的可行性边界。
三、端侧AI芯片技术演进:从算力堆叠到异构计算
3.1 从“算力堆叠”到“异构计算”
端侧AI芯片的竞争规则正在被重写。云端芯片的逻辑是“一力降十会”,算力即正义;而端侧面对的是功耗只有几瓦、成本卡在几十美金、却要跑得动大模型的“不可能三角”。端侧AI的核心不是功能有多全、跑分有多高,而是在有限物理约束下把推理效率逼到极致。
SoC从传统音视频处理向“高NPU算力+低功耗+强ISP”升级。芯片行业正形成低功耗入门级(<1TOPS)、中算力主流级(1-16TOPS)、高算力高端级(≥16TOPS)的金字塔结构。人形机器人等高端场景对64TOPS以上算力芯片的需求激增。
3.2 三大芯片技术方向
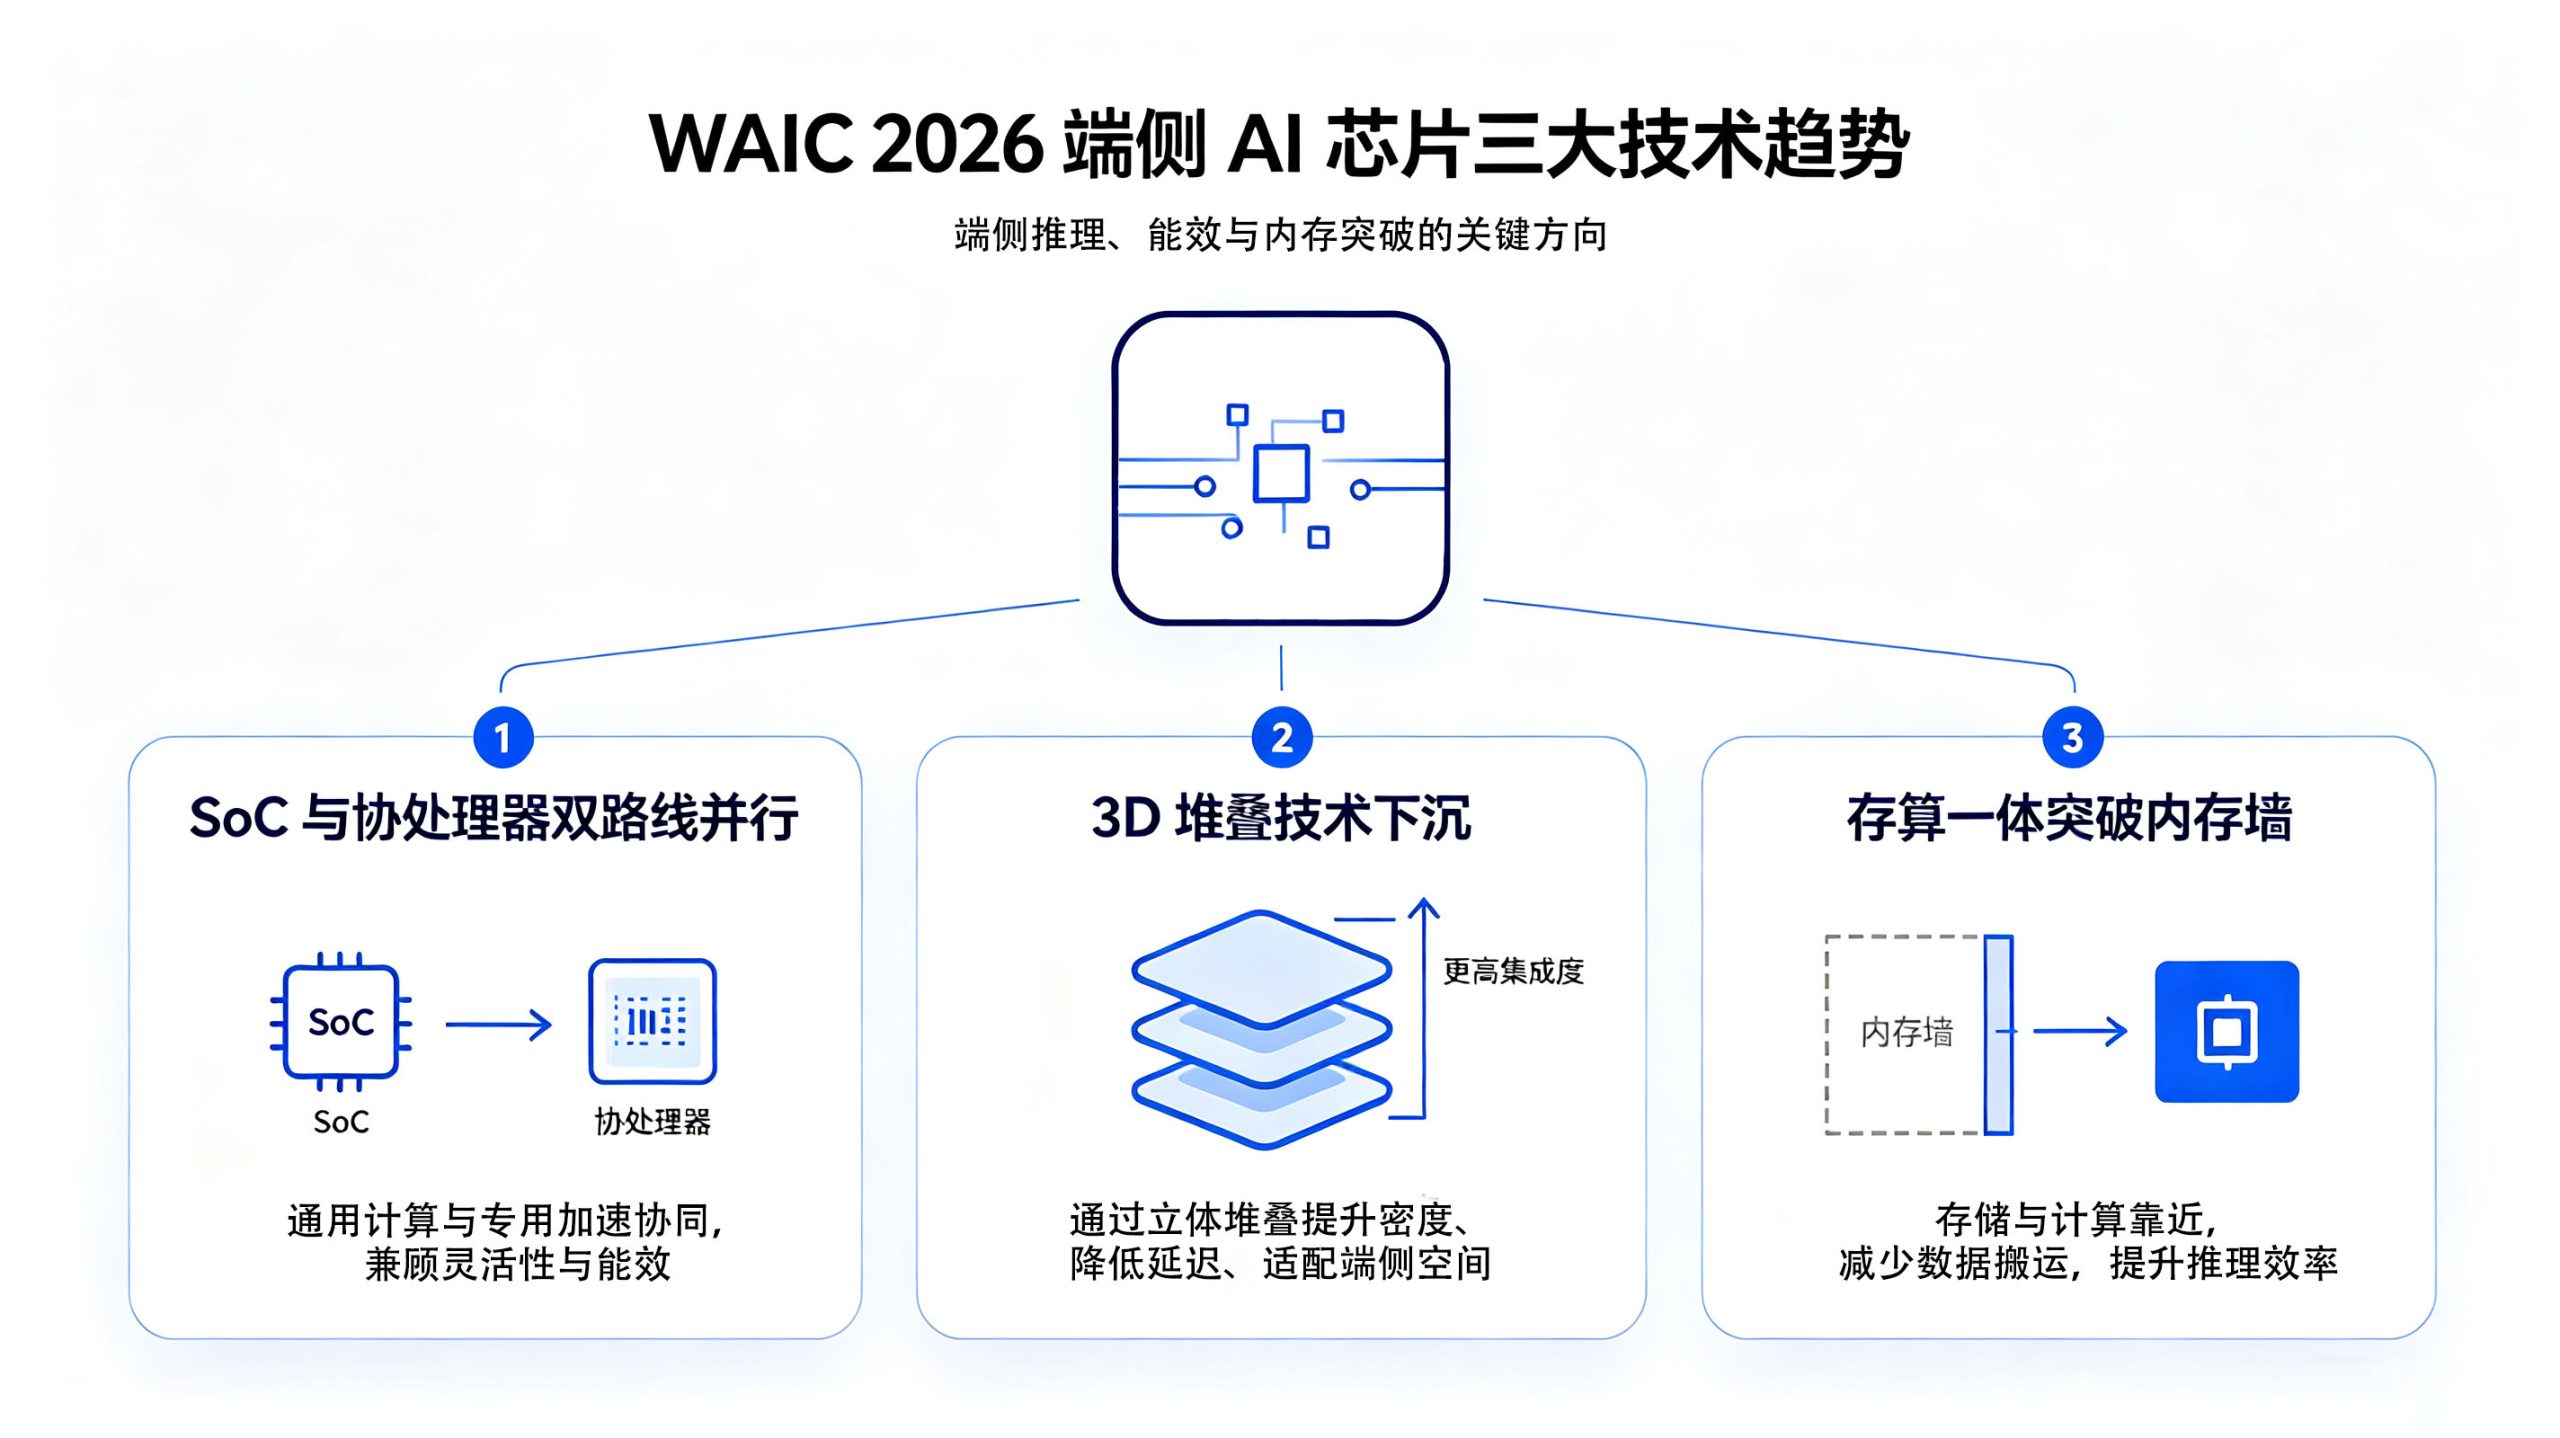
WAIC2026上,端侧AI芯片展现出三大技术趋势:
一是SoC与协处理器双路线并行。SoC路线以瑞芯微RK3588为代表,将CPU、GPU、NPU集成于单芯片,搭载6TOPSNPU,已渗透进AIoT千行百业。协处理器路线则作为“AI外挂”通过标准接口与主控协同工作,客户可在不推翻原有系统的情况下平滑升级算力。
二是3D堆叠技术下沉。Transformer推理的带宽瓶颈已被产业界公认——再快的计算核心,数据搬不过来也是白搭。光羽芯辰TC1000依托自研3D堆叠近存算架构,实现等效带宽10倍跃升,同等算力下功耗仅为传统方案的1/3。华润微电子与陆兮科技发布首款3D堆叠类脑端侧AI推理芯片。
三是存算一体突破内存墙。端侧跑大模型,算力从来不是第一瓶颈,内存带宽和OS调度才是。移动端内存带宽普遍在30-50GB/s区间,远低于服务器级GPU。存算一体技术通过在芯片内集成存储与计算单元,直接突破“内存墙”约束。
3.3 端云协同成为主流架构
业界正在形成的共识是“端侧为主、云端为辅,优先在本地处理、解决不了再上云”的混合架构。未来主流解决方案中,本地推理能满足的场景先用本地,本地做不了的再上云端。这一架构的确立,意味着端侧AI不再是云端AI的补充,而是AI能力输出的主阵地。
四、端侧AI规模化落地的挑战与未来趋势
4.1 当前面临的核心挑战
端侧AI规模化落地仍面临多重挑战:
“不可能三角”困境:终端设备的体积、电池功耗、散热空间都存在刚性限制。运行4B模型时设备表面温度可在5分钟内升至45℃以上,功耗较待机状态增加300%-400%。
内存墙瓶颈:很多时候模型跑不动不是因为算不过来,而是数据根本搬不过来。当模型跑不动的原因不是算力不够而是数据搬不过来时,堆TOPS就是无效努力。
杀手级应用缺失:端侧AI目前还没有出现真正的“杀手级应用”。目前AI手机的功能大多只体现在内置的独立App上,与普通手机的体验差别尚未大到足以驱动换机决策。
部署碎片化:端侧芯片架构天然多元——NPU、GPGPU、DSA、RISC-V、ARM等并存,形成“N种模型×M种芯片×K种终端”的组合难题。北京智源人工智能研究院打造的FlagOS统一软件栈已实现对18家厂商、32款AI芯片的全场景支持。
4.2 未来发展方向
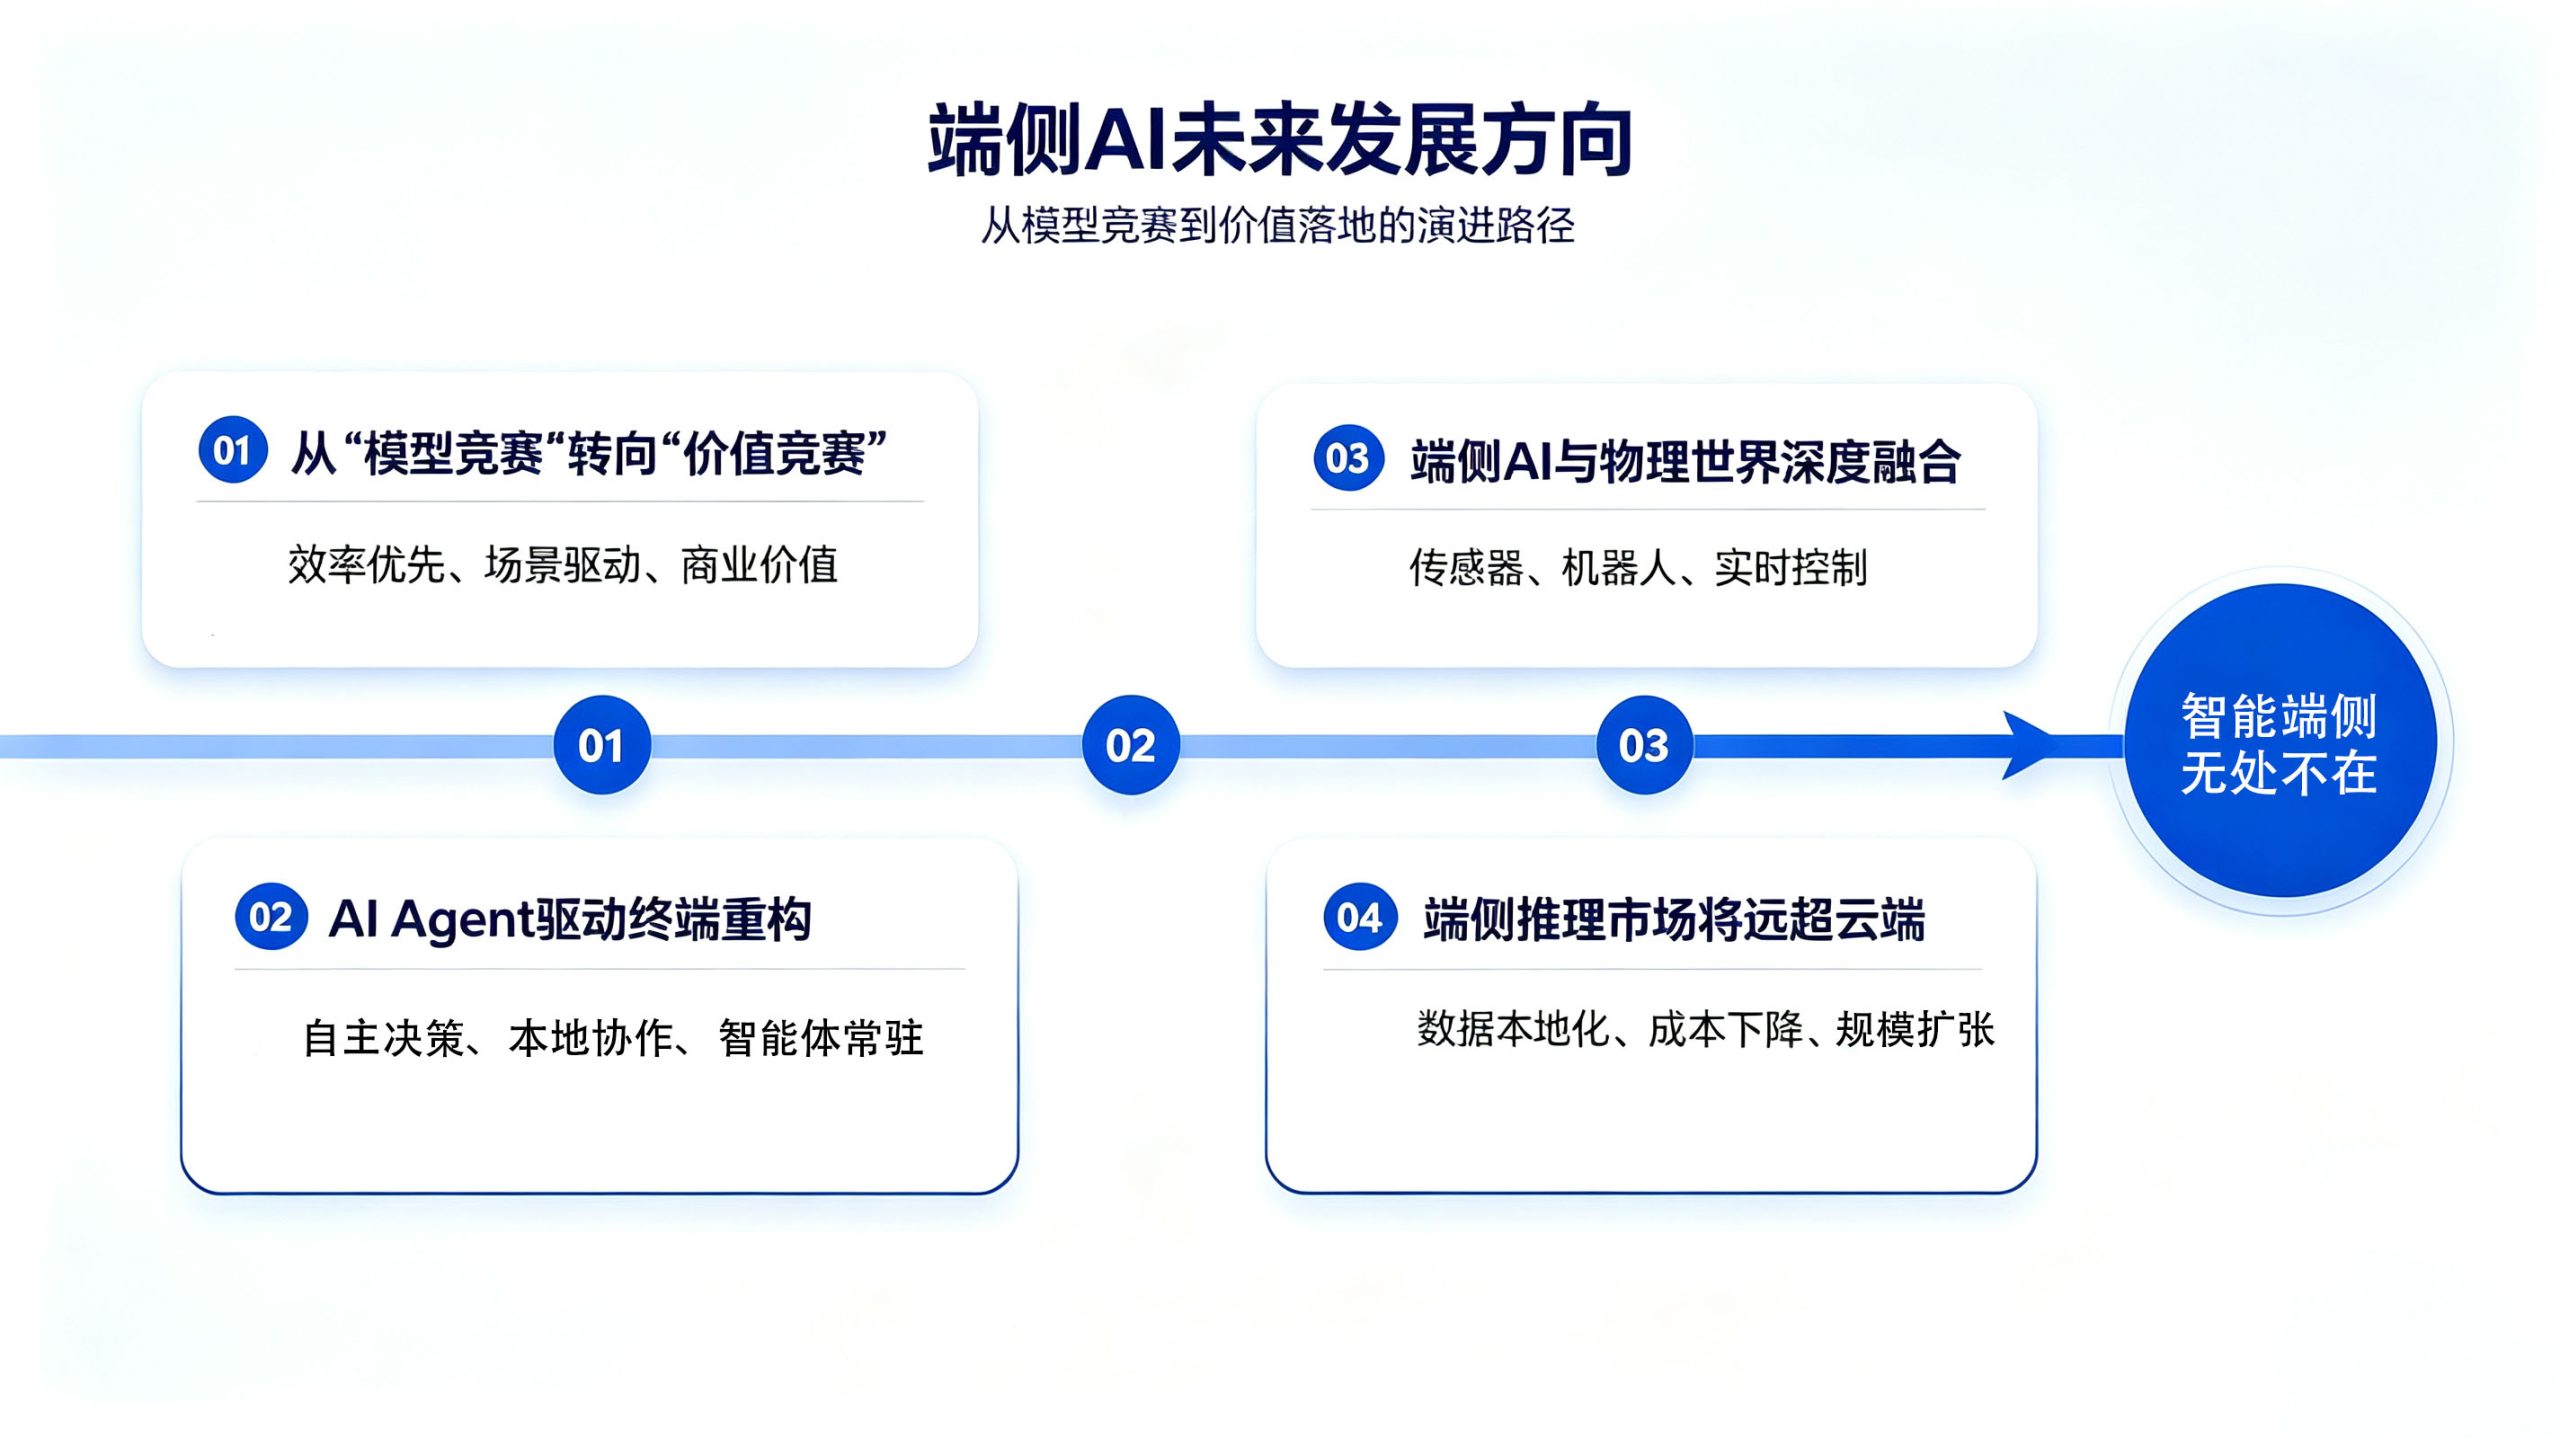
一是从“模型竞赛”转向“价值竞赛”。未来2-3年,端侧行业将从模型效率、工程化能力、场景落地深度等维度展开竞争。AI的价值锚点正在从知识密度转向行动密度,一个会聊天的模型靠云端就够了,而一个会做事的模型必须走向端侧。
二是AI Agent驱动终端重构。AIAgent从“会聊天”走向“真干活”,不仅意味着推理需求增长,也在重新定义终端设备。手机、PC、机器人、汽车和可穿戴设备的AI化升级,将打开新的硬件投资空间。AI终端的长期市场规模或达10万亿至15万亿美元。
三是端侧AI与物理世界深度融合。AI正在从“回答问题”向“执行任务”加速转变。人形机器人从展台走向产线,在模拟产线上展示真实作业能力。具身智能、智能座舱、智慧家庭等场景将成为端侧AI规模化落地的主战场。
四是端侧推理市场将远超云端。聆思科技判断,端侧推理市场将比云端大一个数量级。随着智能体进入PC、手机、机器人、汽车等终端,推理算力需求将持续爆发。
五、瑞迅科技端侧AI硬件产品矩阵与行业应用
瑞迅科技深耕ARM嵌入式工控领域近二十年,围绕瑞芯微RK3568、RK3576、RK3588平台打造了从入门到旗舰的全系列嵌入式工控主板与机器人控制主板,形成覆盖轻量级AGV、中型仓储物流到高端具身智能场景的梯度化产品矩阵。
瑞迅科技紧跟瑞芯微AIoT 2.0趋势,基于RK3588/RK3576主控+RK182X AI协处理器打造双芯协同方案,具备强劲的多模态并行处理能力,可同时支撑视觉导航、避障识别、实时语音交互、长文本对话、场景智能判断等复杂任务,广泛适配商用服务机器人、教育互动终端、工业巡检机器人、智能导引设备等场景。
在工业与边缘安防领域,瑞迅科技基于双芯异构算力平台打造的AI处理方案,专为园区安防、工地监控、智能制造视觉巡检等场景深度定制,可广泛落地工厂产线AI质检、车间智能巡检、智慧教室AI交互等轻量化端侧AI应用。